
English · Nederlands
Wie AI-functies per token prijst, koppelt zijn omzet aan de enige input in het product die het snelst goedkoper wordt. Het voelt verstandig. Het is een val die langzaam dichtgaat.
Waarom prijzen per token goed voelt
Als een SaaS-bedrijf AI toevoegt, komt het eerste prijsmodel meestal van finance. Tokens zijn de enige kostenpost die je vanaf dag één kunt meten. Verpak ze in credits, zet er een marge op, en elke verkoop ziet er veilig uit.
Het probleem is de trendlijn. Bij een gelijk niveau van kunnen zijn de prijzen van LLM-API’s met een factor 9 tot 900 per jaar gedaald, afhankelijk van de taak (Epoch AI). Anderen houden het op ongeveer een factor 10 per jaar (a16z). Welk cijfer je ook neemt: je verankert je prijs aan een grondstof in vrije val.
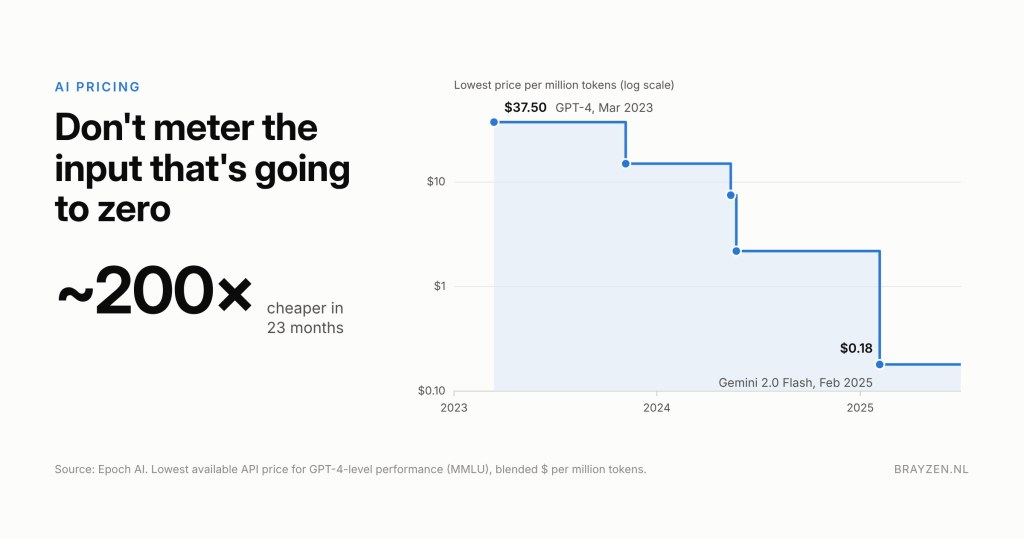
Dat alleen is al een margeverhaal. Twee structurele verschuivingen maken er een strategisch probleem van.
Breuk één: van functies naar agents
De AI-functies van nu zijn vooral incrementeel. Een gebruiker stelt één vraag, het systeem doet één aanroep naar het model, jij telt de tokens. Kosten en gebruik bewegen mee, dus een credit per vraag voelt eerlijk.
Agents verbreken die koppeling. Eén verzoek waaiert uit in talloze modelaanroepen, zoekacties en tools, waarover de agent zelf beslist terwijl hij bezig is. Dezelfde taak kan op dinsdag tien keer zoveel kosten als op maandag, afhankelijk van het document, de route die de agent kiest en hoe vaak hij zijn eigen werk controleert.
Daar volgen drie dingen uit:
- Kosten worden grillig en onvoorspelbaar. De klant kan de rekening niet voorspellen, dus inkoop kan die niet goedkeuren.
- Kosten volgen de waarde niet meer. Een lastige casus kan veel credits verbranden voor een antwoord van weinig waarde; een eenvoudige kan een dag werk besparen voor een fractie van een cent.
- De meter straft het product als het goed werkt. Een agent die continu op de achtergrond monitort, opstelt en handelt, is precies de belofte. Meet je zijn tokens, dan factureer je de klant het meest precies op het moment dat de agent zijn werk doet.
Staat er “agents” op je roadmap, dan is een prijsmodel op basis van tokens nu al achterhaald.
Breuk twee: de rekenkracht verhuist naar de klant
De tweede verschuiving is stiller. Grote organisaties weigeren steeds vaker AI van derden op gevoelige data. Ze kiezen zelf een model, draaien het binnen hun eigen omgeving of soevereine cloud, en vragen leveranciers daarop aan te sluiten. “Bring your own model” schuift van een niche-wens naar een vinkje in de aanbesteding, vooral in gereguleerde sectoren en bij de overheid.
Dan gaan jouw tokenkosten vrijwel naar nul. De klant betaalt de inferentie. Maar jij levert nog steeds de domeinkennis, de workflow, de data en de audit trail die het antwoord bruikbaar maken.
Een prijs op basis van tokens meet dan de enige input die jij niet meer levert, en negeert alles wat de klant écht van je koopt. Je beste, meest beveiligingsbewuste klanten worden precies de klanten die jouw model niet kan beprijzen.
Waar de klant eigenlijk voor betaalt
Als het geen tokens zijn, wat dan wel? Het is verleidelijk om “onze data” te zeggen. Wees voorzichtig. Veel domeindata is openbaar of wordt dat binnenkort, en het deel dat telt is meestal recent, niet twintig jaar archief.
In mijn ervaring zit de verdedigbare waarde van een verticaal SaaS-product met AI op drie plekken:
- Nabijheid van het live proces. Het werk loopt via jouw platform, dus jij ziet wat er nú gebeurt. Die doorlopende context kan een generieke assistent niet krijgen door een document in een chatvenster te plakken.
- Het systeem van vastlegging. Jouw output heeft bewijskracht: gelogd, herleidbaar en controleerbaar. In werk waar compliance zwaar weegt, telt dat meer dan hoe slim het antwoord is.
- Het netwerk. Werken beide kanten van een markt op jouw platform, dan maakt elke transactie beter wat je de volgende klant kunt vertellen.
Daarbovenop zit de orkestratie die je engineers al schrijven: prompts, vangrails voor het ophalen van informatie, controles, de begeleiding van agents. Verdeeld over duizenden klanten is dat echte waarde. Niets daarvan wordt in tokens gemeten.
Wat je in plaats daarvan doet: twee lagen
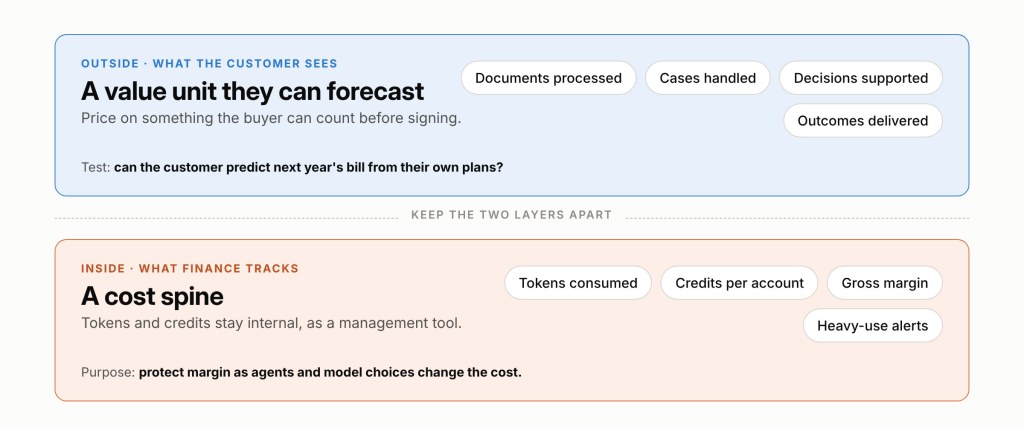
Je hoeft niet te doen alsof kosten niet bestaan. Splits ze in twee lagen en houd die gescheiden.
Binnen: een kostenruggengraat. Gebruik credits of tokens intern om verbruik te volgen, je marge te bewaken en zware gebruikers te herkennen. Finance heeft dit nodig. Klanten hoeven het nooit te zien.
Buiten: een waarde-eenheid die de klant kan inschatten. Prijs op iets wat de koper vóór ondertekening kan tellen: verwerkte documenten, afgehandelde zaken, ondersteunde beslissingen, geleverde resultaten. De toets is simpel: kan de klant de rekening van volgend jaar voorspellen op basis van zijn eigen plannen? Zo niet, dan stokt inkoop of dwingt die korting af.
De markt beweegt al deze kant op. Salesforce begon met Agentforce op $2 per gesprek, zette nieuwe klanten over op Flex Credits van $0,10 per agentactie, en verkoopt nu ook $2 per opgelost gesprek en licenties per gebruiker. Opvallend: elke actie wordt gemeten ongeacht hoeveel tokens ze gebruikt (analyse van Macha op basis van de Salesforce-tarieven). Fin, voorheen Intercom en nu onderdeel van Salesforce, rekent $0,99 per opgelost gesprek en niets als het mislukt (Voiceflow).
Het spectrum ziet er zo uit:
| Eenheid waarvoor je rekent | Klant kan het voorspellen | Volgt de geleverde waarde | Wie draagt het kostenrisico |
|---|---|---|---|
| Tokens | Nee | Nee | Klant |
| Agentacties | Deels | Deels | Gedeeld |
| Gesprekken of taken | Ja | Deels | Leverancier |
| Resultaten (opgelost, besloten, gewonnen) | Ja, mits goed gedefinieerd | Ja | Leverancier |
Hoe verder naar beneden in de tabel, hoe meer kostenrisico jij draagt, en hoe meer je kunt vragen. Prijzen op resultaat heeft een eigen valkuil: de definitie van een resultaat wordt het contract. Schrijf die zo dat een koper ermee akkoord zou gaan in een geschil.
Er is een nuttig precedent buiten AI. Analyticsleveranciers prijzen al lang op server calls, een eenheid die de klant uit zijn eigen verkeersdata kan voorspellen. Hetzelfde principe geldt: de klant moet gebruik en uitgaven aan elkaar kunnen koppelen vóór hij koopt, niet pas als de factuur binnenkomt.
Marge is een buffer, geen strategie
Veel AI-functies starten met brutomarges boven de 90% op tokenkosten. Prima als vertrekpunt. Een ruime marge koopt je tijd om te leren hoe klanten de functie echt gebruiken, voordat je weet wat je moet vragen.
Verwar het niet met een slotgracht. Is je prijs zichtbaar een veelvoud van de tokenkosten, dan hoeft een concurrent alleen maar te delen. Tokenprijzen blijven dalen, dus het veelvoud blijft groeien, en de race naar nul begint bij wie het eerst onder je prijs duikt. De bescherming: prijs vanaf het begin op waarde, zodat dalende kosten je marge vergroten in plaats van een prijsoorlog uit te lokken.
Twee praktische regels helpen:
- Bezuinig nooit op modelkwaliteit bij een functie die omzet moet opleveren. Krijgt een klant een beter antwoord door hetzelfde document in een gratis chatbot te plakken, dan heb je geen product.
- Publiceer geen prijs per credit die je niet hebt gekalibreerd. Het eerste getal dat je laat zien, wordt jarenlang het anker. Laat de klant een eenheid zien die hij begrijpt en houd de kosten per credit intern.
De korte versie
Tokens zijn de juiste manier om je kosten te sturen en de verkeerde manier om je prijs te bepalen. Agents maken tokenkosten onvoorspelbaar, modellen die de klant zelf draait laten ze verdwijnen, en de prijs per token blijft hoe dan ook dalen. Bouw een kostenruggengraat voor finance, geef de klant een waarde-eenheid die hij kan voorspellen, en laat dalende inferentiekosten jouw marge worden in plaats van de kans voor je concurrent.
Ontwerp je AI-pricing voor een SaaS-platform en wil je je model langs deze breuklijnen testen? Neem contact op.
Verder lezen
- Cloud Licensing (2011, Engels): dezelfde spanning tussen eenvoudig, flexibel en voorspelbaar prijzen, één technologiegolf eerder.
- T-Mobile Buddy Finder (2011, Engels): “hoe kan ik dit per minuut factureren?”, de oerversie van de tokenvraag.